树状数组
它的实现比线段树更短,但初看时可能更难理解。
树状数组也叫做 Fenwick Tree,名字来自它的发明者。
假设我们有一个数组 ,并且希望支持以下两种操作:
- 更新:修改 中某个元素的值;
- 查询:求某个前缀和 的值。
树状数组,也称为二叉索引树(binary indexed tree),是一种可以高效处理这两种操作的数据结构。需要注意的是,即使这种结构的名称中包含“树”,我们也可以把它看作一个数组 ,其中 存储一个区间 的和, 由函数 确定。
暴力解法
这个问题有两种朴素解法。
第一种是直接维护数组 。对于更新操作,我们只需要修改一个元素。对于查询操作,我们遍历所需前缀中的所有元素来计算它们的和。
void update(int pos, int val) {
    A[pos] = val;
}

int query(int pos) {
    int sum = 0;
    for (int i = 1; i <= pos; i++) {
        sum += A[i];
    }
    return sum;
}
这种解法可以在 时间内处理更新,但查询速度相当慢,需要 时间。
第二种朴素解法是维护所有前缀和。假设我们有一个数组 ,其中 。 如果我们更新元素 ,就需要更新所有 ,其中 。为了回答查询,我们只需要检查 中的一个元素。
void update(int pos, int val) {
    int difference = val - A[pos];
    for (int i = pos; i <= N; i++) {
        S[i] += difference;
    }
}

int query(int pos) {
    return S[pos];
}
第二种朴素解法在 时间内处理更新,但查询很快,只需要 。
对朴素解法的解释
从某种意义上说,这两种解法彼此互补。一种快速执行更新而查询较慢,另一种则恰好相反。这类情况的目标通常是找到某种折中方案。
考虑一下这两种朴素解法中,我们为每个位置维护了什么。第一种解法中,对于位置 ,我们维护长度为 的区间 ;而第二种解法中,我们维护长度为 的区间 。
当我们想要计算直到某个下标为止的所有元素之和时,在这两种解法中,我们都是删除以当前下标结尾的区间,然后跳转到该区间中没有包含的第一个值。
当我们更新某个位置的值时,需要更新所有包含该位置的区间。
Fenwick 树的结构
为了改进之前的解法,我们需要在区间长度较长和较短之间取得平衡,这样既可以避免包含过多区间,也不需要在一个值发生变化时更新太多区间。如果所有区间的长度都相同,那么最好的平衡方式是使用 作为区间长度。这是一种常见技巧:当你对某个问题有两个大小分别为 和 的部分时,通常取 可以使它们达到平衡。
但是我们可以做得更好,因为我们认为区间的长度可以取小于等于 的最大的 2 的幂。
下面给出了当 时区间的一种图形表示。
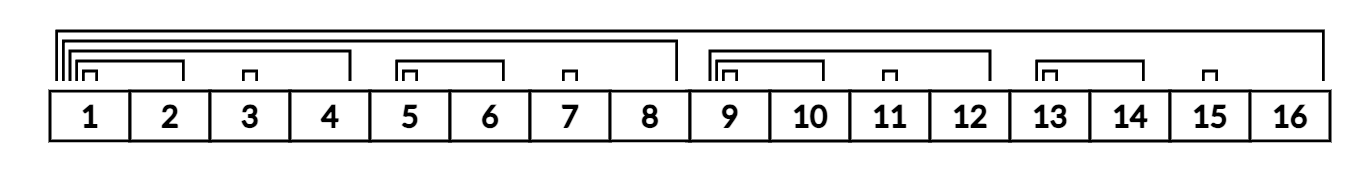
这些区间看起来似乎有些奇怪。
我们把 设为下标为 的区间的长度。基本上,我们先从所有长度均为 的区间开始:
我们将展示如何以 2 的幂为长度,逐步构造 。
-
对于 ,它只有一个长度为 的区间,因此 .
-
下一步是 。我们取前一个 的副本,并将第一个位置的和改为两者之和。。
-
为了得到下一个 2 的幂对应的 ,我们取之前的 ,复制一份,并将最后一个元素改成 。因此,在 的情况下,将前一个 复制后得到 , 但随后我们将最后一个元素改为 ,于是 。
-
对于 ,有 。·
-
对于 ,我们得到 。·
但是树在哪里?
到目前为止,这个数据结构看起来仍然只是在维护一些区间和,并没有真正的树。不过如果仔细观察,可以发现两个区间要么完全不相交,要么其中一个完全包含在另一个中。这意味着我们可以把区间集合解释成一棵有根树,其中某个区间的父亲是包含它的最短区间。
例如,长度为 且末端为 的区间的父亲,是长度为 且末端为 的区间;长度为 且末端为 的区间的父亲,是长度为 且末端为 的区间。沿着一个区间的父亲不断向上,就可以到达更大的区间。
既然我们已经找到了隐藏的树结构,接下来有两个重要细节需要弄清楚。
区间长度
首先,给定下标 ,我们如何计算以 为右端点的区间长度?我们把它定义为能够整除 的最大的 2 的幂。这有点难直接得到,但如果能够写出一个公式就会很好。我们可以编写下面的函数:
int length(int pos) {
    int ans = 0;
    while ((pos >> ans) & 1 == 0) {
        ans++;
    }
    return (1 << ans);
}
这段代码需要 步,但幸运的是,由于数字的二进制表示方式,有一种更快的求法。为了表示一个负数 ,我们取 的二进制表示,将所有位取反,然后加 (忽略最后的进位)。来看一个数字用 8 位表示的例子:
 x = 00111000
~x = 11000111
-x = 11001000
注意,从右侧开始, 和 中的位在某一位之前都相同,而这一位之前的那些位都会发生变化。因此, 会得到我们所需要的值,在本例中:
8 == x & (-x)
现在,我们有了一种可以在 时间内求出区间长度的方法:
int len(int pos) {
    return pos & -pos;
}
找到所有包含某个下标的区间
既然我们已经知道,所有区间要么不相交,要么其中一个包含另一个,那么这一部分就可以通过不断沿树向上移动来完成。类似地,包含某个给定下标的最小区间,总是可以通过求该下标与其父亲之间的差得到。
如果 是 2 的幂,那么这个差就等于 ,因为它的父亲是下一个 2 的幂。否则,我们可以再次利用 Fenwick 树的递归结构。对于 的前一部分,该差等于能够整除 的最大的 2 的幂,也就是 。
你也可以这样理解:下标 的父亲是这样一个位置——它所对应区间的长度,等于我们已经知道如何计算的 的区间长度的两倍。
当我们修改位置 pos 的值时,它的父亲也会变化,父亲的父亲同样会变化,依此类推。
在下面的函数中,我们把第一个参数作为需要更新的位置,第二个参数表示新值与旧值之间的差:
void update(int pos, int val) {
    while (pos <= N) {
        fenwick[pos] += val;
        pos += lowbit(pos);
    }
}
查询
对于查询,我们从所查询的下标开始,把它所对应区间的和加入答案,然后向左移动。这样做时我们知道区间的长度,因此:
int query(int pos) {
    int sum = 0;
    while (pos > 0) {
        sum += fenwick[pos];
        pos -= lowbit(pos);
    }
    return sum;
}
复杂度分析
有两个重要性质可以帮助我们:
- 一个区间的父亲,其大小至少是该区间的两倍;
- 一个区间中位于其左侧的区间,其大小至少是该区间的两倍。
这意味着,对于两个操作中的每一个,我们最多执行 步,因此复杂度为
这正是我们一直在寻找的折中方案。
参考代码
#include <bits/stdc++.h>
int main() {

}
寻找第 个元素
假设需要一种数据结构,它除了支持 C++ set 的所有操作外,还支持:
order_of_key(x):统计集合中严格小于x的元素数量。find_by_order(k):与find类似,返回集合中第k小元素对应的迭代器(下标从零开始)。
顺序统计树
幸运的是,C++ 已经有这样的内置数据结构。不过它只受 GCC 支持,Clang 用户无法使用。
使用树状数组
不过,如果所有更新都在 范围内,也可以用树状数组完成相同操作。
使用线段树
这会在铂金组的线段树二分中讲解。
逆序对计数
实现
使用带下标集合,只需几行代码就能解决这个问题。
#include <bits/stdc++.h>
using namespace std;

#include <ext/pb_ds/assoc_container.hpp>
using namespace __gnu_pbds;
template <class T>
using Tree =
    tree<T, null_type, less<T>, rb_tree_tag, tree_order_statistics_node_update>;

int main() {
	int test_num;
	cin >> test_num;
	for (int t = 0; t < test_num; t++) {
		Tree<int> tree;

		int arr_len;
		cin >> arr_len;
		long long inv_num = 0;
		for (int i = 0; i < arr_len; i++) {
			int x;
			cin >> x;
			/*
			 * Calculate the # of elements in the tree
			 * that are greater than x.
			 * (.order_of_key(x) gives the # of elements less than x)
			 */
			inv_num += i - tree.order_of_key(x);
			tree.insert(x);
		}

		cout << inv_num << '\n';
	}
}
注意,如果输入数组的元素并非互不相同,这段代码就是错误的,因为 Tree<int> 会去除重复值。
此时应使用数对的带下标集合(Tree<pair<int,int>>),其中每个数对的第一个元素表示值,
第二个元素表示该值在数组中的位置。
题目
如果坐标很大(例如达到 ),应在使用树状数组或线段树前进行 坐标压缩 (不过也可以使用动态开点线段树。)