线段树
大多数金组区间查询问题要求在大小为 的数组上,以每次 的时间支持以下操作:
- 修改单个位置(点)上的元素。
- 查询某个连续子数组的元素和。
线段树和树状数组都能完成这些操作。
线段树能对任意满足结合律的运算(不只是求和),以每次 的时间完成单点修改和区间查询。
线段树的英文为 Segment Tree,其中 segment 表示区间。
基础问题
在本课中,我们将介绍一种在算法竞赛中经常出现的数据结构。线段树(segment tree) 的主要用途,是解决这样一类问题(或子问题):在一个数组上持续接收一系列 查询(queries) 和 更新(updates),并且需要在线回答这些查询。我们来看一个例子:
给定一个包含 个整数的数组 ,下标从 到 ,以及 个操作,每个操作属于以下两种之一:
- update:给定 和 ,将 修改为 ;
- query:给定 和 ,求
输出每次查询的答案。
直接的解决方案
在接下来的课程中,我们把给定数组的一个子数组称为一个 区间(segment)。
解决这个问题时,首先想到的方法,是遍历查询区间中的所有元素,然后直接找出其中的最大值,时间复杂度为
而在更新操作中,只需把 修改为 ,时间复杂度为 。
优化思路
为了便于说明,我们假设 是 2 的幂,即 。
现在,你可以这样理解上面的解决方案:我们已经计算出了所有长度为 1 的区间的答案(区间 的最大值就是 )。这些区间可以在 时间内完成更新,但是一次查询需要由 个这样的区间组成。
如果我们再多计算出一些区间的答案,并且以一种聪明的方式维护它们呢?这样一来,虽然在一次更新时可能需要重新计算不止一个区间,但一次查询所需要的区间数量却可以显著减少。
很好,但是现在我们应该维护哪些区间呢?
我们将总共维护 个区间:1 个长度为 的区间,2 个长度为 的区间,4 个长度为 的区间,以此类推。它们的结构如下所示:
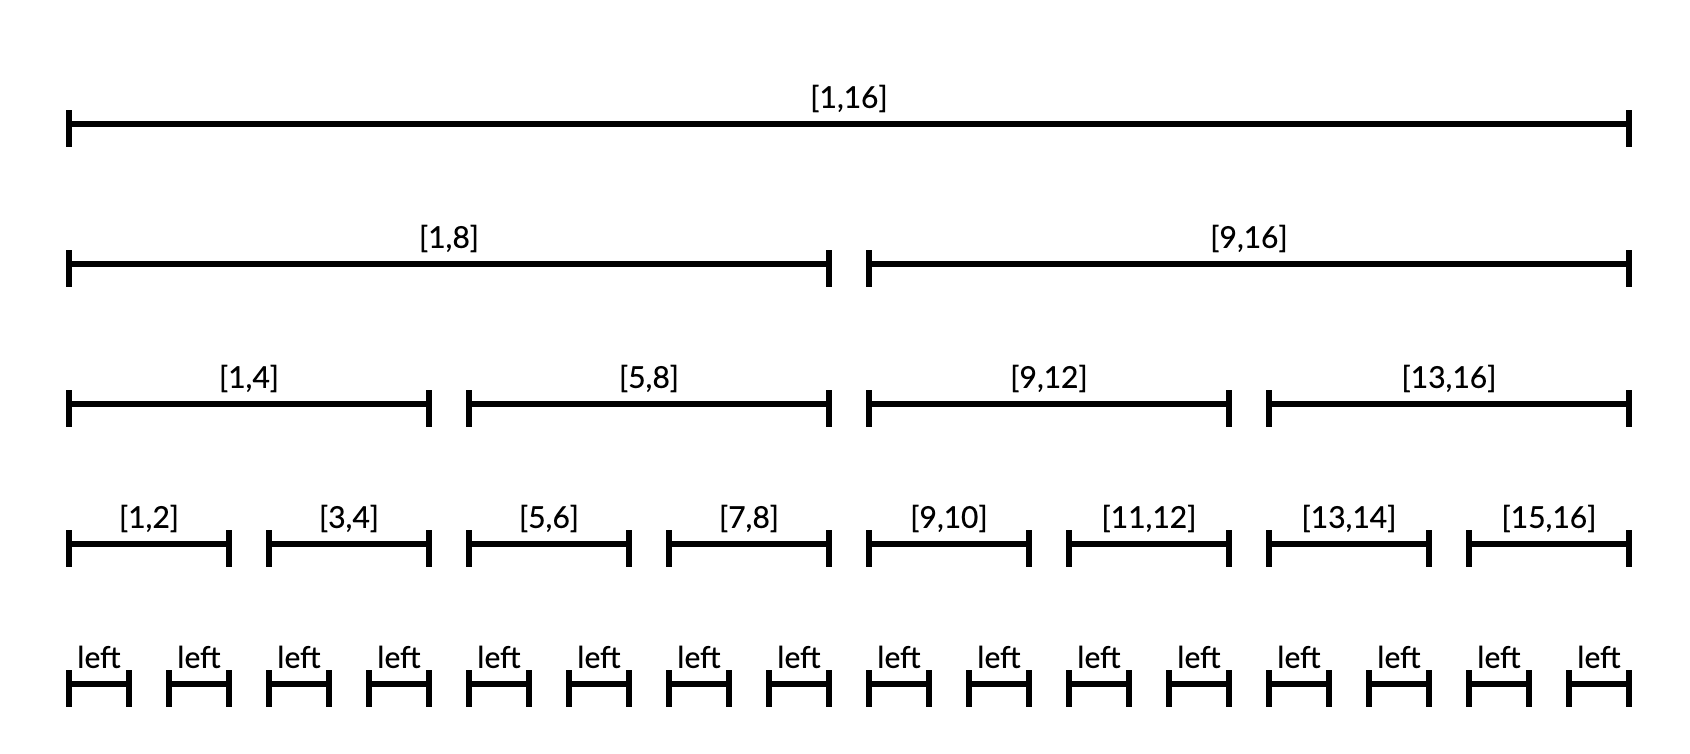
每一个长度为 的区间,都会被分成两个长度为 的区间。从现在开始,我们把这两个区间称为它的 儿子(sons)。而这个区间本身,则称为这两个区间的 父亲(father)。
很自然地,我们便产生了把这些区间维护成一种 树形结构(tree-like structure) 的想法。
线段树
线段树具有一棵 满二叉树(full binary tree) 的结构,因此可以像 堆(heap) 一样,以一个简单数组的形式存储在内存中。
其中,树根的编号为 0;编号为 的区间的父亲为 ,它的两个儿子分别为 和 。下面是前面那些区间以树形方式表示时的样子:
如果 不是 2 的幂,那么唯一的变化在于:如果一个区间的长度是奇数,那么它的左半部分长度为 ,而右半部分长度为 。这棵树将不再是一棵满二叉树,但其他所有性质仍然成立。
构建线段树
为了让线段树能够工作,你必须能够根据一个区间的两个儿子的答案,计算出这个区间的 答案(solution)。
对于示例问题,一个区间上的最大值,就是它两个儿子的答案中的较大值,因此计算方式如下:
对初始数组构建线段树将通过递归方式完成,因为每个区间都能够根据存储在它两个儿子中的答案来计算自己的答案。对于线段树中存储的几乎任何信息,这个函数看起来都是相同的:
struct SegmentTree {
    int l, r;
    int dat;
} t[SIZE * 4]; // SIZE 为维护的区间长度

void build(int p, int l, int r) { //"p" 是数组中的下标,而 "l" 和 "r" 是当前区间的两个端点
    t[p].l = l, t[p].r = r;
    if (l == r) {
        t[p].dat = a[l]; // 我们位于一个叶节点
        return;
    }
    int mid = (l + r) / 2;
    build(2 * p, l, mid);
    build(2 * p + 1, mid + 1, r);
    t[p].dat = max(t[p * 2].dat, t[p * 2 + 1].dat);
}

build(1, 1, N);
每个叶节点被访问了一次,非叶节点也只会被访问一次,叶节点有 个,非叶节点有 个,每个节点内,做的是赋值,合并等常数操作,所以构建的时间复杂度为 ,即 。
利用主定理分析
递推式子为 。由主定理可知时间复杂度为 。
更新
对于一次 update 类型的操作,我们需要在考虑 新值的情况下,重新计算若干个区间。 如果仔细观察这些区间的结构,可以发现,下标 在每一层中恰好只出现在一个区间里。 由于一共有 层,因此当 发生变化时,也会有 个区间需要更新。
需要更新的区间,就是从树根到第 个叶节点这条路径上的那些区间,因此,再次从根节点开始进行递归调用就足够了。
void update(int p, int x, int v) {
    if (t[p].l == t[p].r) { //we are in the xth leaf
        t[p].dat = v;
        return;
    }

    int mid = (t[p].l + t[p].r) / 2;
    if (x <= mid) { //we need to update the left son
        update(2 * p, x, v);
    } else {
        update(2 * p + 1, x, v);
    }
    t[p].dat = max(t[p * 2].dat, t[p * 2 + 1].dat);
}
update(1, x, v);
从跟节点到最后更新的节点,每层只有一个节点被访问修改,所以一次修改的时间复杂度为 。
查询
对于一次 query 类型的操作,我们会把查询区间拆分成若干个在线段树中已经保存了答案的区间。 为了理解一次查询需要哪些区间,你可以先想象:一开始,我们希望这个区间集合包含从 到 的所有叶节点。 然后,只要集合中存在两个拥有同一个父亲的区间,就把它们删除,并把它们的父亲加入集合。 下面就是一个查询区间拆分之后的样子(查询 ):
[3, 11],红色节点表示查询过程中被完整覆盖的区间。当然,在真正实现时,我们会反过来进行:还是从树根开始,如果查询区间和左儿子的区间存在交集,就向左儿子递归;如果查询区间和右儿子的区间存在交集,就向右儿子递归。 当我们到达一个完全包含在查询区间内的区间时,就直接返回这个区间的答案。
int query(int p, int l, int r) {
    if (l <= t[p].l && r >= t[p].r) return t[p].dat;

    int val = -(1 << 30);
    int mid = (t[p].l + t[p].r) / 2;
    if (l <= mid) val = max(val, query(2 * p, l, r));
    if (r > mid)  val = max(val, query(2 * p + 1, mid + 1, r, x, y));
    return val;
}
这实际上有多快呢?
正如我们在实现中所看到的那样,函数可能会同时递归到两个儿子,因此一次查询究竟会访问多少个节点,并不是特别明显。 查询一开始只会沿着其中一个儿子向下,直到某个位置,它会向两个方向分裂。 把发生第一次分裂的节点称为 ,并把它的两个儿子称为 和 。图示大致如下:
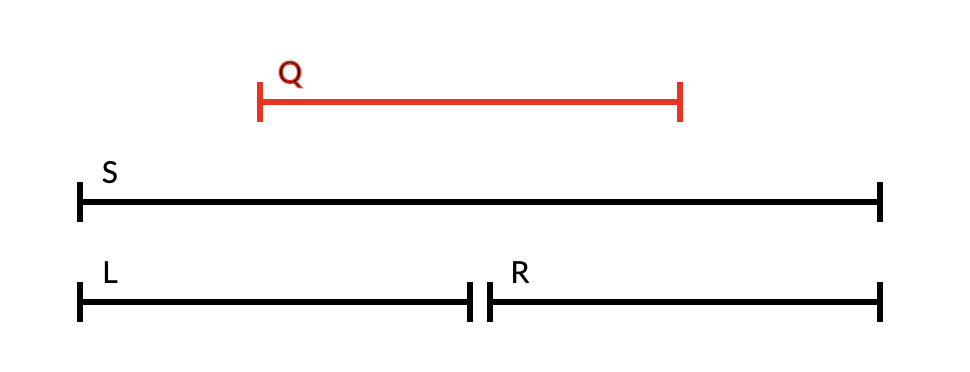
由于查询区间也与 相交,所以查询区间的右端点位于 的右端点的右边。 另外,由于这是第一次发生分裂,这意味着查询区间完全包含在 的区间中,因此 的左端点位于查询区间左端点的左边。
根据这些观察,我们可以看到:如果从 开始继续向下,并且再次发生分裂,那么分裂产生的 右儿子 一定会完全包含在查询区间中,因此它可以在 时间内直接得到答案。 对于第一次分裂之后沿着右儿子向下时发生的那些分裂,它们的 左儿子 也是同样的情况。 因此,在第一次分裂之后,两边最多都只会访问 个节点。所以,总的来说,每次查询的时间复杂度为 。