FHQ Treap
1. FHQ Treap 是什么?
FHQ Treap,也叫 无旋 Treap,是一种常用的随机平衡二叉搜索树。
它可以维护一个动态有序集合,支持:
| 操作 | 含义 | 时间复杂度 |
|---|---|---|
插入 x | 加入一个数 | 期望 O(log n) |
删除 x | 删除一个数 | 期望 O(log n) |
| 查询排名 | 查询 x 是第几小 | 期望 O(log n) |
查询第 k 小 | 查询排名为 k 的数 | 期望 O(log n) |
| 查询前驱 | 小于 x 的最大数 | 期望 O(log n) |
| 查询后继 | 大于 x 的最小数 | 期望 O(log n) |
它的特点是:
- 不需要旋转。
- 核心只有两个操作:
split和merge。 - 写法比 Splay 简洁。
- 很适合维护有序集合,也可以扩展到维护序列区间操作。
2. Treap
Treap = Tree + Heap。
Treap 是 二叉搜索树(BST)和堆(Heap)的结合体,它既满足 BST 的性质,也满足堆的性质。
具体来说,每个节点有两个关键值:val(权值) 和 pri(优先级)。
-
二叉搜索树性质
对于任意节点
u, 该节点的权值不小于它的左子树中任意节点的权值。 该节点的权值不大于它的右子树中任意节点的权值。BST维护了树中元素的权值大小顺序,由此,我们才能快速查找和删除某个排名的元素。 -
堆性质
父节点的优先级值永远大于子节点的优先级值(小于亦可)。
因为
pri是随机生成的,所以树高期望是O(log n)。正因如此,才能在删除、添加元素以后,依然保持左右子树的平衡。
Treap 的结构是确定的,这里,确定的意思是,给出若干个 和 给定的节点,在 val 和 pri 都不相等的前提下, 个 建立的 Treap 一定是一样的形态。这是因为,pri 最大的节点一定是跟节点,所有值小于等于根节点的节点将被划入左子树,其余节点划入右子树,同理,左右子树的根节点依然是确定的,依次类推,可以得知,整棵树的形态固定。
普通 Treap 通常通过 旋转 保持堆性质。而 FHQ Treap 不旋转,而是通过两个操作 split 和 merge来完成所需的操作。
3. 节点设计
用下面的结构体来保存节点
struct FHQ {
  int ls, rs, pri, sz, val;
} fhq[N];
// ls 左儿子 rs 右儿子
// pri 随机值,用来表示优先级
// sz 子树大小
// val 节点的值
当子树的大小发生变化以后,通过 push_up 函数更新父节点的子树大小。
void push_up(int u) {
  fhq[u].sz = fhq[fhq[u].ls].sz + fhq[fhq[u].rs].sz + 1;
}
4. 核心操作
merge
merge(x, y) 用来把两棵 Treap 合并成一棵。
merge 的前提是子树 中所有节点的值小于等于子树 中所有节点的值。merge 之后,依然要满足 Treap 的性质。
如果 的 pri 值 大于 的 pri 值,那么合并后, 的 pri 值最大,将作为根节点,同时, 的左子树上的节点的权值都小于等于 的权值,它们依然作为 的左子树出现,而 的右子树和子树 ,这些节点的权值都大于等于 ,它们合并一棵 Treap 以后,作为 的右子树出现。
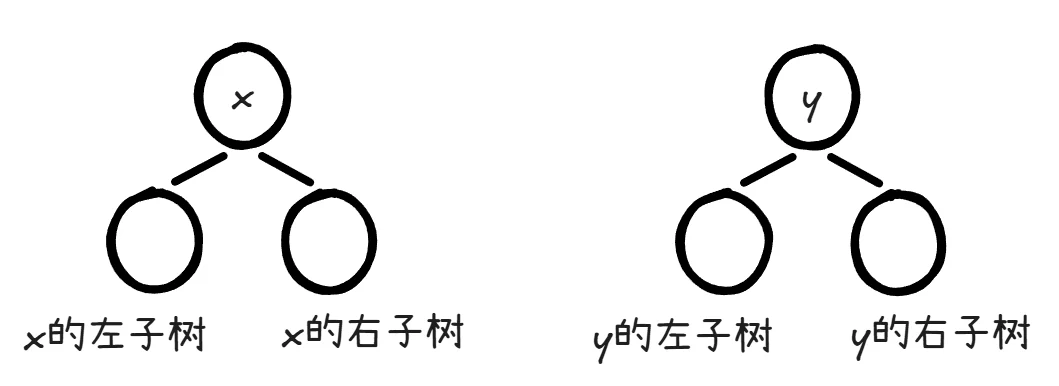
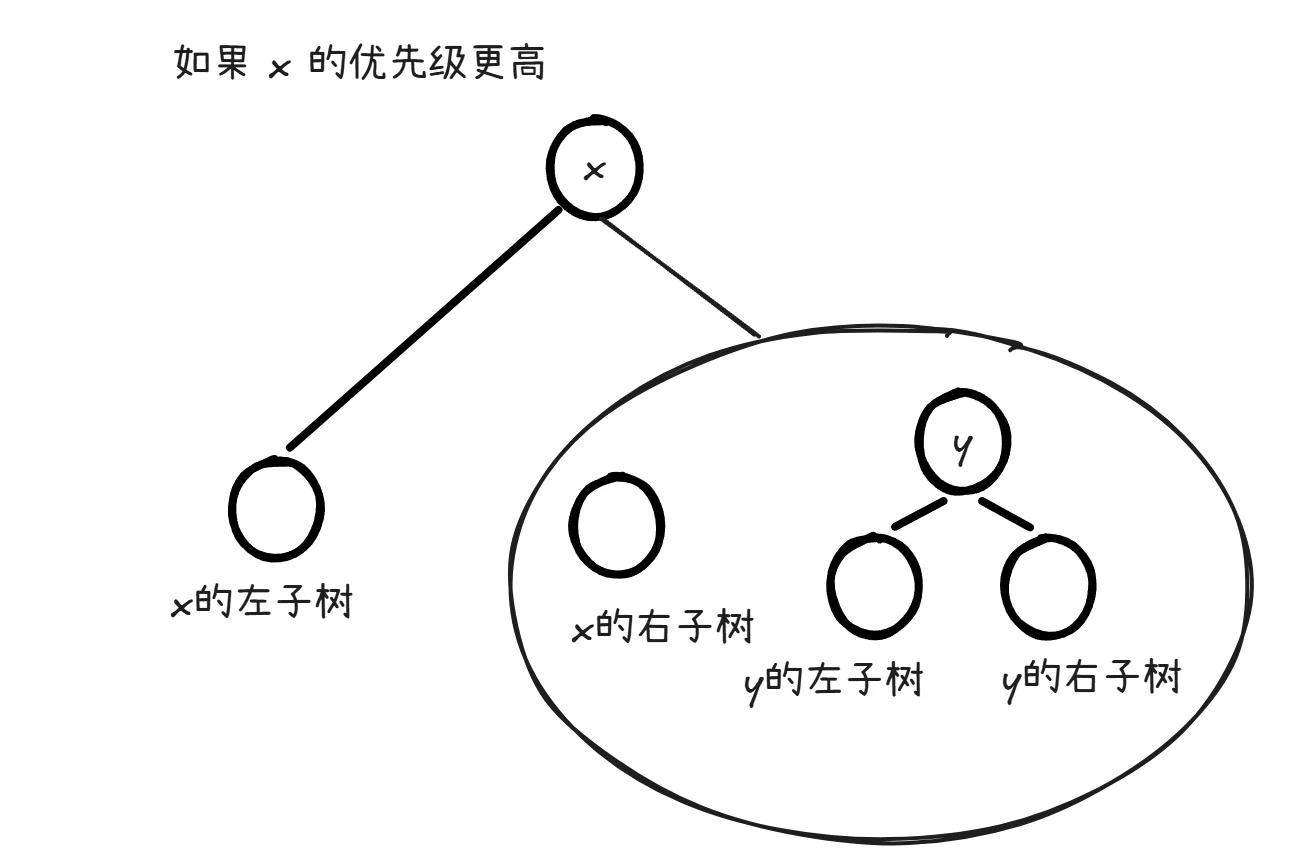
因此,我们的操作步骤是
如果 pri[x] > pri[y],那么首先递归合并 的右子树和 ,然后,将合并后的树设为 的右子树, 的左子树保持不变。合并后的树的根节点依然是 。
对于 pre[x] < pri[y] 的情况类似
int merge(int x, int y) {
  if (!x || !y) return x + y;
  if (fhq[x].pri > fhq[y].pri) {
    fhq[x].rs = merge(fhq[x].rs, y);
    push_up(x);
    return x;
  }

  fhq[y].ls = merge(x, fhq[y].ls);
  push_up(y);
  return y;
}
split
split 用来将一棵 Treap 按照权值 分裂为两棵 Treap,其中一棵 Treap用 表示, 内的节点的权值都小于等于 ,另一棵 Treap 用 表示, 内节点的权值都大于 。
记当前节点是 u。
如果 ,说明 u 和它的左子树都应该放在 x 这一边,u 作为 x 的根节点。 的右子树里面可能有一部分也 ,所以继续分裂右子树。右子树将分裂为两棵子树,节点值均小于等于 的子树将作为 u 的右子树,节点值均大于 的子树将作为 。
如果 ,说明 u 和它的右子树都应该放到右边 y。但 u 的左子树里面可能有一部分 ,所以继续分裂左子树。情况和上面类似。
void split(int u, int v, int &x, int &y) {
  if (!u) {
    x = y = 0;
    return;
  }
  if (fhq[u].val > v) {
    y = u;
    split(fhq[u].ls, v, x, fhq[u].ls);
  } else {
    x = u;
    split(fhq[u].rs, v, fhq[u].rs, y);
  }
  push_up(u);
}
这里 x 和 y 必须用引用,因为要在递归过程中修改它们。
5. 用 split 和 merge 实现基本操作
5.1 插入元素
插入 v 的思路:
-
把原树分裂成两部分: 和
-
新建节点
v。 -
合并:
root = merge(merge(T1, New(val)), T2);
代码:
void insert(int val) {
  split(root, val, T1, T2); // T1, T2 用来临时保存分裂后的两颗树根节点编号
  root = merge(merge(T1, New(val)), T2);
}
5.2 删除元素
删除一个值 v 的思路:
-
先把树分成三部分:,,
-
然后从 中删掉一个节点。
-
因为 里面全是
v,删除根节点即可。
void erase(int val) {
  split(root, val - 1, T1, T2);
  split(T2, val, T3, T4);
  T3 = merge(fhq[T3].l, fhq[T3].r);
  root = merge(merge(T1, T3), T4);
}
5.3 查询 x 的排名
排名定义为:比 小的数的个数 。
int find_rank(int x) {
  split(root, x - 1, T1, T2);
  int res = fhq[T1].sz + 1;
  root = merge(T1, T2);
  return res;
}
5.4 查询第 k 小
因为每个节点维护了子树大小,所以可以像权值线段树一样往下找。
int kth(int k) {
  int u = root;
  while (u) {
    int tmp = fhq[fhq[u].l].sz + 1;
    if (tmp == k) return fhq[u].val;
    if (tmp > k) u = fhq[u].l;
    else k -= tmp, u = fhq[u].r;
  }
  return fhq[u].val;
}
5.5 查询 x 的前驱
前驱:小于 v 的最大数。
int find_pre(int x) {
  split(root, x - 1, T1, T2);
  int u = T1;
  while (fhq[u].r) u = fhq[u].r;
  root = merge(T1, T2);
  return fhq[u].val;
}
5.6 查询后继
后继:大于 v 的最小数。
int find_next(int x) {
  split(root, x, T1, T2);
  int u = T2;
  while (fhq[u].l) u = fhq[u].l;
  root = merge(T1, T2);
  return fhq[u].val;
}
6. FHQ Treap 和权值线段树的区别
FHQ Treap 和权值线段树都可以维护排名、第 k 小、前驱后继。
但是它们适用场景不同。
| 数据结构 | 适合场景 |
|---|---|
| 权值线段树 | 值域较小,或者可以离散化 |
| FHQ Treap | 值域很大,动态插入删除,不方便离散化 |
| Splay | 需要复杂序列操作,或者需要伸展性质 |
| set / multiset | 只需要前驱后继,不需要排名和第 k 小 |
如果题目只需要前驱、后继,set 通常更简单。
如果还需要排名、第 k 小,FHQ Treap 就很合适。
7. FHQ Treap 维护序列
上面的 FHQ Treap 是按照 val 分裂,用来维护有序集合。FHQ Treap 还有一种重要用法:维护序列。这时候不再按照 val 分裂,而是按照子树大小分裂。
例如有序列:
a1 a2 a3 a4 a5
可以用 Treap 的中序遍历表示这个序列。
如果要分裂出前 k 个数,就写:
split_by_size(root, k, x, y);
含义:
x: 前 k 个元素
y: 剩下的元素
7.1 按大小分裂
void split_by_size(int u, int k, int &x, int &y) {
    if (!u) {
        x = y = 0;
        return;
    }

    if (fhq[fhq[u].l].sz + 1 <= k) {
        x = u;
        split_by_size(fhq[u].r, k - fhq[fhq[u].l].sz - 1, fhq[u].r, y);
        pushup(x);
    } else {
        y = u;
        split_by_size(fhq[u].l, k, x, fhq[y].r);
        pushup(y);
    }
}
7.2 区间翻转的思路
如果要翻转区间 [l, r],可以分裂成三段:
[1, l - 1], [l, r], [r + 1, n]
代码形式:
int a, b, c;

split_by_size(root, l - 1, a, b);
split_by_size(b, r - l + 1, b, c);

rev[b] ^= 1;

root = merge(a, merge(b, c));
这里 rev[b] ^= 1 表示给中间这一段打翻转标记。
不过维护序列时,需要写 pushdown,把翻转标记下传。